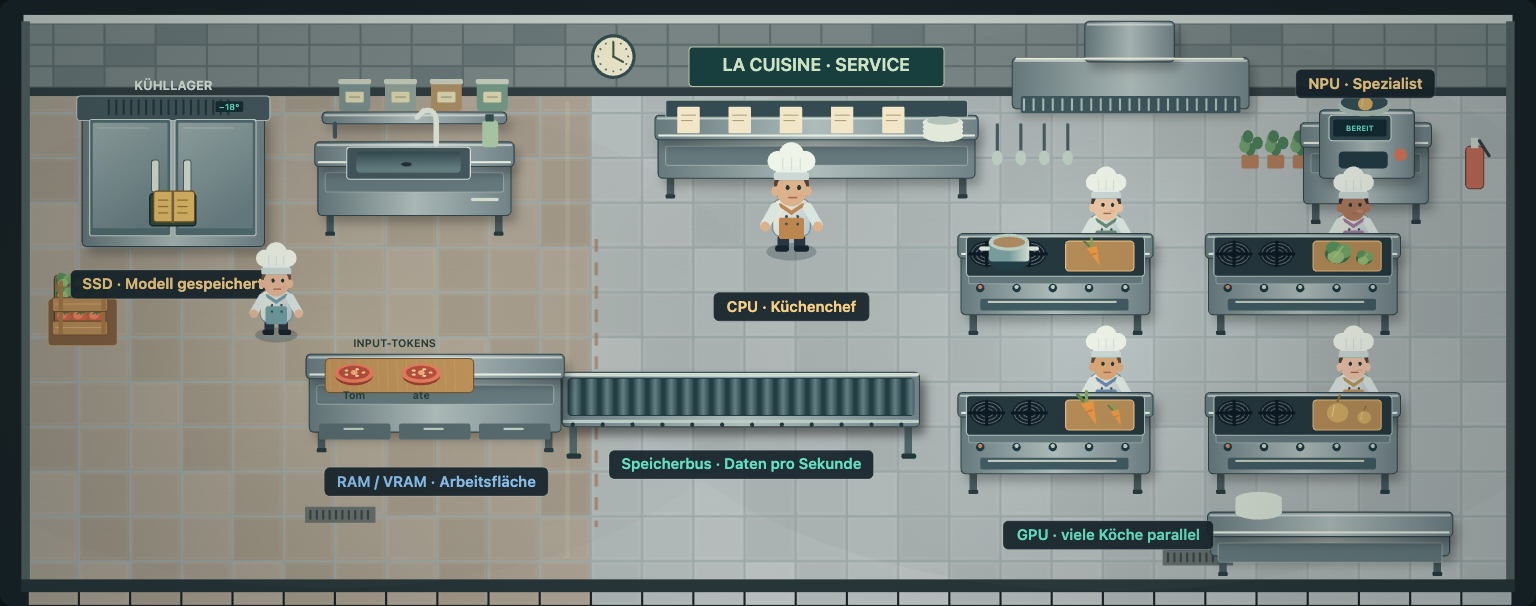
A prompt becomes tokens. A model processes them. New tokens become an answer. I built this kitchen for my Demystifying KI talk so you can follow the process, pause it, and explore it for yourself.
 13 scenes / 2:47 with narration / Free
One request, from ingredients to the bill.
See why one word can contain several tokens, why a model needs working memory, and how input and output affect the cost.
The animation and narration are in German. Start with “Mit André starten”. Pause, move between scenes, or switch the voice and kitchen sounds off separately. On a phone, landscape gives the kitchen more room.
← All writing01 / What to look for
Three things to take away.
Words become tokens.
The tokenizer divides the input and context into pieces and assigns token IDs. One word does not always equal one token.
Memory makes room.
The recipe book stands for learned weights. Storage holds them; working memory makes them available while processors do the computation.
Tokens add up.
Input and generated output can have different prices. The CHF amounts in this kitchen are fictional examples, not provider prices.
02 / Sprechtext auf Deutsch
Szene für Szene nachlesen.
01 Tokens 19 s
Bevor wir in die Küche gehen, brauchen wir einen Begriff: Token. Ein Sprachmodell verarbeitet Text in kleinen Einheiten. Ein Wort kann ein Token sein oder mehrere. In unserem Beispiel: Hallo eins, Tomate zwei, Tomatensalat vier. Die genaue Aufteilung hängt vom Tokenizer ab.
Diese Szene öffnen ↗02 Tokenisierung 15 s
Zuerst zerlegt der Tokenizer unsere Eingabe samt Kontext und ordnet jedem Stück eine Nummer zu. In der Küche entspricht das dem Schneiden und Portionieren. Erst danach verarbeitet das Modell die vorbereitete Eingabe.
Diese Szene öffnen ↗03 Die Küche 10 s
Jetzt gehen wir in die Küche. Der Text ist die Zutat, Tokens sind die vorbereiteten Stücke. Das Rezeptbuch steht für etwas anderes: die gelernten Modellgewichte.
Diese Szene öffnen ↗04 Das gespeicherte Modell 13 s
Im Lager liegt das gespeicherte Modell. Im Computer ist das zum Beispiel die SSD. Zum Arbeiten laden wir es in schnellen Speicher. Das ist etwas anderes als die Vorbereitung unserer Anfrage.
Diese Szene öffnen ↗05 Arbeitsspeicher 11 s
Auf der Arbeitsfläche liegen Modellgewichte und Daten der Anfrage bereit. Der Platz ist begrenzt. Eine separate Grafikkarte hat dafür eigenen Speicher: den VRAM.
Diese Szene öffnen ↗06 CPU 7 s
Die CPU ist unser vielseitiger Küchenchef. Sie organisiert den Ablauf und übernimmt auch selbst Aufgaben.
Diese Szene öffnen ↗07 GPU 10 s
Die GPU ist das Küchenteam. Viele ähnliche Rechnungen laufen parallel. Genau diese Art von Rechenarbeit brauchen neuronale Netze.
Diese Szene öffnen ↗08 NPU 12 s
Die NPU ist ein Spezialgerät für bestimmte KI-Rechnungen. Welche Einheiten tatsächlich arbeiten, hängt vom Gerät und der Software ab. Nicht jede Anfrage nutzt alle Stationen.
Diese Szene öffnen ↗09 Bandbreite 10 s
Die Stücke sind schon vorbereitet. Jetzt zählt der Transport. Speichergrösse bestimmt, wie viel auf die Arbeitsfläche passt. Bandbreite bestimmt, wie viele Daten pro Sekunde bei den Recheneinheiten ankommen.
Diese Szene öffnen ↗10 Eingabe verarbeiten 13 s
Jetzt arbeitet die Küche zusammen. Unsere Eingabe kommt bereits als Tokens an. Das Modell verarbeitet deren numerische Darstellung mit seinen gelernten Gewichten. Das Tokenisieren haben wir vorher erledigt.
Diese Szene öffnen ↗11 Antwort erzeugen 11 s
Das Modell erzeugt neue Tokens, eines nach dem anderen. Die Anwendung setzt diese Stücke wieder zu lesbarem Text zusammen. Deshalb wächst die Antwort vor unseren Augen.
Diese Szene öffnen ↗12 Token-Kosten 22 s
Und jetzt die Rechnung. Input und Output können unterschiedlich viel kosten. Unsere Küchenpreise sind frei erfunden: ein Franken pro Input-Token, zwei pro Output-Token. Zwei hinein und vier heraus ergeben zehn Franken. Verdoppeln wir beide Mengen, sind es zwanzig. Die echte Rechnung hängt von der Token-Menge und dem Tarif des Modells ab.
Diese Szene öffnen ↗13 Was sich verändert — und was bleibt 14 s
Die Antwort ist fertig. Der Kontext hat sich verändert, die gelernten Modellgewichte sind aber gleich geblieben. Eine Antwort zu erzeugen ist noch kein neues Training. Und damit: Vielen Dank für eure Neugier!
Diese Szene öffnen ↗A useful analogy, with limits.
This illustrates inference: using an already trained model. It is not a simulation of the mathematics, and the weights do not change during the request shown here. The hardware path varies by setup; a CPU, GPU and NPU do not all have to participate.
The narration uses my existing AI voice clone. Audio files and the animation are served with this lesson; playback sends no prompts to a model or speech service.
The kitchen analogy was inspired by the original video’s kitchen explanation ↗. This interactive version, token preparation and illustrative bill were built for my “Demystifying KI” talk.